既存のエンタープライズデータは、AIモデル・エージェント・ワークフロー自動化を動かすナレッジベースとして十分な素地を持っています。問題は、それを実際に活用できているかどうかです。
「ラストマイル問題」がエンタープライズデータの活用を阻んでいる
データは社内のあらゆる場所に存在していますが、ほとんどのチームにとって、それは「もう少しで手が届く」という距離にとどまっています。これはラストマイル問題です。データ自体は確かに存在しています。データウェアハウス、プロダクトアナリティクスデータベース、ERP、HCM、CRM、オブジェクトストレージ、ベクターストアの中に。モデル化され、ガバナンスも整備され、精度も概ね高い。アナリティクスや可視化ツールを通じてアクセスできる状態になっているかもしれません。しかし「会話形式で使える」状態にはなっていません。これらのシステムから意味のある回答を得るには、クエリを書ける人材、想定される質問に対応したダッシュボードを事前に構築できる人材、あるいはすでに手一杯のデータチームのバックログに積まれるチケットを起票する作業が、いずれにしても必要になります。
AIエージェントは、質問からデータドリブンな回答、そしてAIによるアクションへのプロセスにおける摩擦と遅延を解消することを約束しています。高い理想のように聞こえるかもしれませんが、現在の技術スタックは、こうしたギャップを埋めるために思っている以上に近い位置にあるはずです。
すべてのエンタープライズシステムには、クエリインターフェースが備わっています。データウェアハウスはSQL、または類似の言語で動作します。エンジニアリングチームが直接管理するプロダクト・アナリティクスデータベースには、顧客がどのようにプロダクトやサービスを利用しているかを示すトランザクションデータや行動データが格納されています。クラウドインフラにはイベントストリーム、オブジェクトデータ、アプリケーションログが蓄積されています。Snowflake、NetSuite、Workday、SalesforceといったエンタープライズアプリケーションはすべてAPIを公開しており、インテグレーションチームはその扱い方をすでに熟知しています。そして、Qdrant、Pinecone、Weaviateといったベクターデータベースはドキュメント、トランスクリプト、メール、サポートチケットといった非構造化コンテンツのエンベディングを格納しており、クエリが最も難しく、かつ最も価値ある形で表面化できる組織の知見を保持しています。つまり、データ基盤の多くはすでに整っているのです。
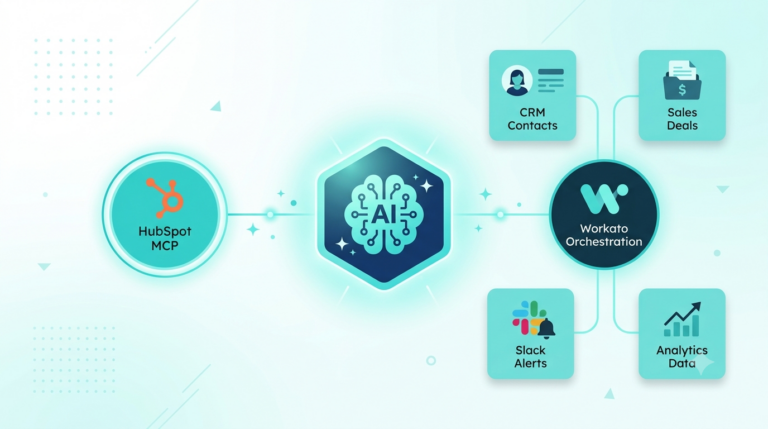
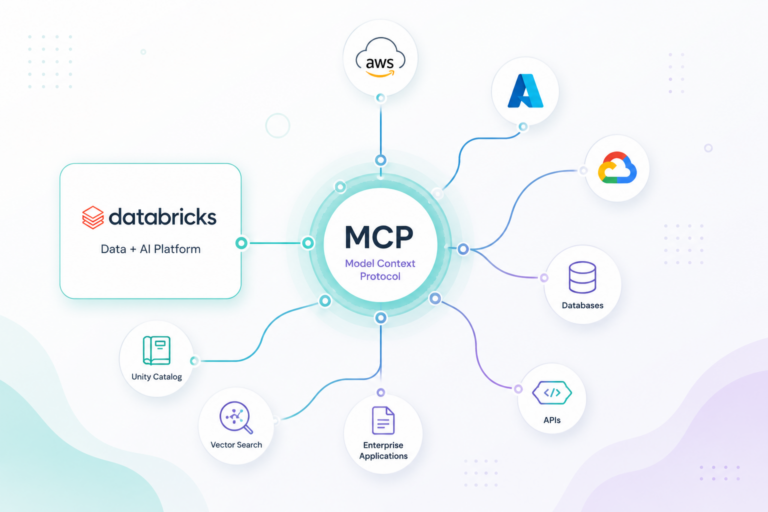
AIエージェントが加えるのは、会話のための変換レイヤーであり、理想的には自動化のためのアクション制御基盤です。自然言語で入力し、適切なシステムへのクエリが実行され、構造化された回答が返ってくる。そして本当に影響力のあるAIエージェントであれば、会話インターフェースから直接ワークフローを起動できます。MCP(Model Context Protocol)は、エージェントとエンタープライズデータ・システムをつなぐ結合組織の標準として定着しつつあります。WorkatoのEnterprise MCPは、オーケストレーションを完全にマネージドされた認証済みのMCPサーバーとして、固有の監査可能なURLとともに公開します。Agent Studioで構築されたエージェントであれ、Claude、Cursor、カスタムモデルといった外部AI環境で動作するエージェントであれ、新しいデータソースごとに専用のAPIインテグレーションを構築することなく、実行時にこれらのツールを検出して呼び出せます。インテグレーションチームにとって、これは大きな意味を持ちます。Workato上で一度接続を構築し、MCPサーバーとして公開すれば、フリート内のすべてのエージェントがそれを利用できます。

ベクターデータベースとグラフデータベースを検索・推論に活用する
上の図において、ベクターデータベースとグラフデータベースがどこに位置するかを明確にしておく価値があります。これらはエンタープライズシステムであり、データウェアハウス、SQLデータベース、ビジネスアプリケーションと並んで、アーキテクチャの最下層に位置しています。これらが際立っているのは、アーキテクチャ上の配置ではなく、格納しているものの性質にあります。ベクターデータベースは「意味」を格納し、グラフデータベースは「関係性」を格納します。どちらもSQLを話さず、BIダッシュボードにもすっきりとは収まりません。しかし、両者は媒介レイヤーに、そしてその上位に位置するエージェントにデータを供給します。
この違いは、何が回答可能かを変えます。データウェアハウスは部門別の人員数を教えてくれます。退職面談のトランスクリプトを格納したベクターストアは、その部門の人々が退職時に実際に語っていた言葉を教えてくれます。グラフデータベースは、退職前にその人々がチーム・マネージャー・プロジェクトをまたいでどのようにつながっていたかを教えてくれます。この3つすべてにアクセスできるエージェントは、データアナリストとHRパートナーが数日かけて作成するような回答を統合して導き出すことができます。それはダッシュボードの問題ではありません。検索と推論の問題であり、まさにエージェントが解くために設計された課題です。
問うべき問いは「エージェントを構築するかどうか」ではありません。「何体構築するか、そしてそれぞれが必要な知識を確実に持てるようにするにはどうするか」です。

「私は組織の未来を考えるとき、従業員を管理するだけでなく、エージェントのフリートを管理することになると認識しています。これらのフリートがビジネスゴールに向かって協調して動けるよう、適切にオーケストレーションすることが非常に重要です。」
Stephen Franchetti氏、SamsaraのCIO
これが、Agentic AIで素早く動いているエンタープライズと、いまだにパイロットを続けているエンタープライズを分けている設計原則です。問うべき問いは「どのようにAIエージェント用のナレッジベースを構築するか」ではありません。「組織内のあらゆる機能にわたってエージェントを動かすことができ、各機能がすでに依存しているシステムから継続的に更新されるナレッジベースアーキテクチャを、どのように構築するか」です。
WorkatoのAgent Studioは、まさにそのために構築されています。Agent Studio内のナレッジベースは、一度作成して手動で管理し続ける静的なドキュメントリポジトリではありません。ナレッジレシピによって最新状態が維持される、ライブインデックスです。ナレッジレシピとは、接続されたシステムからスケジュールまたはイベントトリガーに従ってデータを取得し、その結果をセマンティクスインデックス化されたエージェントがクエリ可能なストアに書き込む、自動化されたWorkatoワークフローのことです。ナレッジベースはそれ自体で構築されていきます。あなたがすべきことは、適切なソースを接続することです。
典型的なエンタープライズスタックにおいて、これが何を意味するかを考えてみましょう。
データウェアハウスは、ビジネスの定量的な鼓動を保持しています。財務パフォーマンス、顧客の健全性、プロダクトの採用状況、業務指標などです。ナレッジレシピはそれを定期的にクエリし、関連するエージェントを常に最新の状態に保ちます。手動のキュレーションも、古くなったエクスポートも、間に入るアナリストも不要です。
プロダクトのSQLデータベースは、それとは異なる同様に価値ある情報を保持しています。行動データです。顧客はプロダクトをどのように実際に使っているか。どの機能を使い、どの機能を使わなくなり、どこで詰まっているのか。WorkatoのSQLコネクタにより、ナレッジレシピはそのデータに直接アクセスでき、CS・プロダクト・サポートチームに対応するエージェントにプロダクトインテリジェンスをリアルタイムで届けられます。
ERPとHCMシステムは、財務部門とHRが対応に多大な時間を費やしている業務・人員データを保持しています。予算差異、未処理の発注、決算処理、事業部門別の人員数、報酬バンド分析などです。どちらもAPIとクエリインターフェースを公開しており、ナレッジレシピが継続的に取り込むことができます。このデータは組織内でも特に機密性が高いものに属しており、単一のワークフローが稼働する前に、その上位にAIレイヤーを乗せるプラットフォームが最高水準のセキュリティとコンプライアンスを満たしていることが求められます。
これがWorkatoをベースに構築することのアーキテクチャ上の優位性です。Agent Studio内でエージェントを展開する場合でも、インテグレーションレイヤーを通じて独自のモデルやデータベースをつなぐ場合でも、個々の開発者がその都度適切なセキュリティ判断をしてくれることに依存する必要はありません。それはプラットフォームに組み込まれているべきものです。Workatoのインテグレーションレイヤーが制御の起点です。どのフィールドがインデックスに含まれるか、どのエージェントがどのナレッジベースにアクセスできるか、どのユーザーが何をクエリできるか。これらをITチームが定義します。そして決定的に重要なのは、従業員がエージェントにクエリを投げても、その人が閲覧を許可されている情報しか表示されないという点です。
WorkatoのVerified User Accessは、すべてのエージェントスキルが、共有サービスアカウントではなく、リクエストを行った個人のアイデンティティと権限を使って実行されることを保証します。あるユーザーがHCMシステムの報酬データへのアクセス権を持っていなければ、エージェントを通じてもそれを見ることはできません。権限の境界は、エージェントが触れるすべてのシステムを横断して、その人とともに移動します。このガバナンスの姿勢は、信頼できるプラットフォームの上に築かれなければなりません。WorkatoはSOC 2、ISO 27001、GDPR、HIPAAなど多数の認証を取得しており、最初のエージェントが給与や調達データに触れる前から、コンプライアンスの基盤が整っています。最新のERPとHCMデータをもとに情報を持つエージェントは、現在では財務やHRのアナリストが手動でレポートを作成しなければ答えられない質問に、データを安全に使うためのコントロールを損なうことなく対応できます。それも運が良ければ即日で。
クラウドストレージとサービスは、ドキュメントとイベントのレイヤーを加えます。オブジェクトストレージ内のプロセスガイド、マネージドデータサービス上の分析データ、NoSQLストア内のアプリケーションレコード。これらすべてがナレッジベースに投入でき、エージェントは構造化されたメトリクスだけでなく、業務のコンテキストについても賢くなります。
そしてベクターレイヤーがあります。ドキュメントリポジトリをベクターデータベースに接続するインジェストパイプライン、そして選択したモデルプロバイダーによって生成されたエンベディングにより、すべてのポリシードキュメント、コールトランスクリプト、サポート記事、社内ガイドがセマンティクス検索可能になります。エージェントは数字を知るだけでなく、組織の知見を知るようになります。
ここでEnterprise MCPがフリートのスケーラビリティ機構になります。各エージェントがデータシステムへの直接接続をそれぞれ管理する代わりに、Workatoはインテグレーションをマネージドなサーバーとして公開します。SQLコネクタ、HCM APIインテグレーション、データウェアハウスクエリエンドポイント。それぞれが、あらゆるエージェントが検出して呼び出せる再利用可能でガバナンスされたツールになります。一度構築し、一元的にガバナンスし、あらゆる場所で利用する。エージェントスプロールを考えるエンタープライズアーキテクトにとって、これがフリートを管理可能な状態に保つパターンです。1つのインテグレーションレイヤー、多数のコンシューマー、コネクタ構築の重複ゼロ。
複合的な効果として生まれるのは、フリート内の各エージェントが自分の機能に最も関連するナレッジベースを参照するアーキテクチャです。セールスエージェントはCRMシグナルとプロダクト利用データから、ファイナンスエージェントはERPとウェアハウスのメトリクスから、HRエージェントはHCMのレコードとポリシードキュメントから、サポートエージェントはプロダクトのSQLデータと過去のチケットトランスクリプトから。Workatoプラットフォーム1つ、ガバナンスモデル1つ、そして多数のエージェント。それぞれがビジネスを動かすシステムから継続的に情報を得ています。
「全員のためのAI」がビジネスに実際にもたらすもの
Workatoはこのアーキテクチャを社内で実際に稼働させています。言わば「自分たちのシャンパンを飲んでいる」状態です。自社のSnowflakeデータウェアハウスの上に構築されたAIアナリティクスエージェント「Data Genie」は、承認済みのプロダクト利用データ、アカウントの健全性シグナル、パイプラインアナリティクス、更新見込みインジケーターに対して、全社員が自然言語で直接アクセスできる環境を提供しています。データチームへのチケット起票も、ダッシュボードの更新を待つことも不要です。以前はアナリストが数時間から数日、場合によっては数週間かけて対応していたような重要なビジネス上の問いへの回答を、セールスとマーケティングチームが数秒で得られるようになりました。リソースの状況次第でしたが。社員はデータを活用してより良い仕事をし、より良い顧客体験を創り、ビジネスにおけるより良い意思決定と成果を生み出しています。
商業的なインパクトは具体的です。アカウントチームは、リアルタイムの利用データ、使用トレンド、プロダクトシグナルをもって、これまで以上に準備を整えた状態で更新の商談に臨めます。具体性と信頼性をもって、より高い価値を顧客に提供できるようになりました。利用シグナルを監視するカスタマーサクセスマネージャーは、最適化戦略をもってアカウントをプロアクティブにサポートできます。営業担当者は、四半期ごとのビジネスレビューを待つことなく、チャンピオンが必要とするタイミングに合わせて適切なパッケージとプロダクトを提案できます。データはもとから存在していました。変わったのは、質問から回答までのレイテンシです。それが数日から数秒へと圧縮されました。

カバレッジの変化も同様に重要です。Data Genieは、BIツールを使いこなせる人だけでなく、レベニューチームのすべてのメンバーに分析能力を届けます。SQLを一行も書いたことのないCSMが、「過去30日間で利用が大幅に減少したアカウントはどれか」と質問し、構造化されたデータに裏付けられた回答を得ることができます。セールスリーダーはダッシュボードを開かずに地域別の売上内訳を確認できます。この民主化、分析的な影響力を専門チームに集中させるのではなく、すべての意思決定者に広げることこそ、複利的なリターンが積み上がっていく場所です。
これを実現する責任を負う人々のために改めて強調しておきたいのは、ガバナンスの話が機能の話と同じくらい重要だという点です。Agent Studioはロールベースのアクセス制御、Verified User Access、すべてのエージェントインタラクションに対するフル監査証跡を備えて構築されています。インテグレーションチームは、どのシステムを接続するか、どのフィールドをインデックスに含めるか、どのユーザーがどのエージェントをクエリできるかを管理します。Enterprise MCPはさらにガバナンスのレイヤーを加えます。エージェントがMCPサーバーを通じて行うすべてのツール呼び出しは、認証され、ログに記録され、取り消し可能です。AIレイヤーはデータガバナンスを回避しません。その中で動作します。
インフラはすでにそこにあります。ウェアハウス、プロダクトデータベース、クラウド環境、ERPとHCMのインテグレーション、ドキュメントリポジトリの中に。ほとんどの組織にまだ欠けているのは、これらのシステムをデータを会話可能にするエージェントのフリートへとつなぐアーキテクチャです。最も速く動いているエンタープライズは、完璧なデータ戦略やグリーンフィールドのAIイニシアチブを待っていません。すでに自社が持っているインフラの上にエージェントを展開し、単一のインテグレーションプラットフォームでガバナンスし、社員が質問できるようにしています。
それが変化の本質です。ITが管理するものとしてのデータインフラから、全員が使うものとしてのデータインフラへ。